Article de recherche
Keep It Secret, Keep It (in a) Safe, Then Cast It into the Fire: Engineering AI Act Data Governance — A Practical Guide for Data Teams
Fait correspondre, article par article, les obligations de l’AI Act en matière de données à des choix de conception Data Vault : satellites sensibles, emplacement du contrôle des biais, schéma d’effacement adapté, preuves pouvant survivre à une suppression. 24 pages.
Lire la publication
24 pages. Ouvrez n’importe quelle page en taille réelle, ou utilisez la transcription ci-dessous.
Aller à une page
Lire la transcription du texte
Texte extrait de la publication. Les images des pages en conservent la mise en page d’origine.
Page 1
KEEP IT SECRET, KEEP IT (IN A) SAFE, THEN
CAST IT INTO THE FIRE
Engineering AI Act Data Governance:
A Practical Guide for Data Teams
Lorenzo Colombani
Juriste de formation française, titulaire du CAPA (certificat d’aptitude à la profession d’avocat), LL.M.
(University of Pennsylvania), praticien Data Vault
Chercheur indépendant · lorenzo.colombani@live.fr · ORCID 0009-0009-4207-4300
Prépublication, 2 septembre 2026 · DOI 10.5281/zenodo.22255574

Résumé
Data Vault préserve l’historique ; la protection des données peut exiger qu’une partie de cet historique soit
effacée. L’AI Act de l’UE ajoute des obligations de détection et de correction des biais qui peuvent reposer sur
des attributs sensibles dont le RGPD restreint le traitement. Concilier ces exigences
suppose des décisions sur la collecte, le stockage, la transformation, la mise à disposition, l’usage et la
suppression des données. Cet article rattache certaines obligations de l’AI Act relatives aux données à ces décisions, à l’aide de
Data Vault 2.x et un exemple de présélection de candidats. L’article 4a fait l’objet d’une
attention particulière : l’autorisation qu’il accorde de traiter des données sensibles s’accompagne de six garanties cumulatives,
dont la suppression dès la correction du biais ou à l’expiration du délai de conservation, au premier des deux termes atteint. Les
schémas de mise en œuvre relient chaque exigence pertinente à des preuves, à un
un responsable désigné et un test. Ils favorisent un traitement licite sans fournir une
base légale manquante, ni trancher les interprétations contestées, ni se substituer aux exigences
organisationnelles plus larges de l’AI Act.
Cet article propose une analyse juridique et architecturale générale. Les systèmes particuliers exigent
l’avis d’un conseil qualifié. Les architectures, les attributions de responsabilités et les tests ci-dessous sont
des pratiques d’ingénierie suggérées ; les obligations et conditions légales sont identifiées par les
dispositions correspondantes.
Mots-clés : AI Act européen ; article 4a ; RGPD ; catégories particulières de données à caractère personnel ; Data Vault
2.0 ; tests de biais ; effacement ; gouvernance des données

1
Page 2
Introduction
Un Anneau pour les gouverner tous, Un Anneau pour les trouver, Un Anneau pour les amener tous et dans les
ténèbres les lier.
— Inscription de l’Anneau unique, J. R. R. Tolkien, The Lord of the Rings
Dans The Fellowship of the Ring, le conseil de Gandalf à Frodon sur la manière de traiter l’Anneau Unique
tient en deux temps : « garde-le secret, garde-le en sûreté ». Mais Elrond, se rappelant ce qu’Isildur
refusa de faire lorsqu’il eut l’occasion de détruire l’Anneau, se montra plus radical : le jeter au
feu. Les équipes data ont entendu les trois conseils.
Gardez-le secret. En vertu de l’article 9 du RGPD, l’origine ethnique, la religion, la santé et les autres
catégories particulières de données personnelles ne peuvent être ni collectées ni traitées, sauf
exceptions strictement limitées.
Gardez-le en sûreté (dans un coffre). Dans l’entreposage de données, et dans la méthodologie Data Vault en
particulier, l’expression se vérifie doublement : les données sont mises sous clé, et elles ne changent pas.
Chaque enregistrement est conservé, chaque version, pour de bon ; hubs, links et satellites fonctionnent en ajout seul.
C’est ce qui donne aux analystes métier qui s’appuient sur l’entrepôt l’auditabilité,
la traçabilité et la confiance dans les chiffres. Et comme Data Vault permet de scinder les satellites, de sorte
que les données personnelles puissent figurer dans un satellite PII dédié, à l’écart des données purement métier, la
méthode se prête naturellement à la conformité au RGPD. « Le client 33 a acheté l’article 8 au magasin
45 le 19 décembre 2022 » est une information commerciale utile et a sa place dans un simple
satellite. « Jean Dupont a acheté un crucifix à la boutique de l’abbaye du Mont-Saint-Michel le 19
décembre » laisse supposer qu’il est chrétien, à tort ou à raison, et a sa place dans le
satellite sensible. Mieux vaut prévenir que guérir. Sur les données sensibles, la réglementation et l’entrepôt
ont toujours été d’accord.
Jetez-le au feu. Puis vint l’AI Act, et avec lui le feu. Avant qu’un modèle à haut risque
puisse inspirer confiance, ses concepteurs doivent en tester les biais : montrer, par exemple, qu’aucun groupe ethnique ou
religieux n’est sur- ou sous-représenté dans les données d’entraînement, ou que le modèle
ne tire aucune conclusion erronée sur l’un d’eux, par exemple que Jean est chrétien. Or ces
contrôles sont impossibles sans connaître l’origine ethnique ou la religion de chacun : l’équipe data
doit collecter et traiter précisément les données que le RGPD lui demande de garder secrètes. À première vue,
l’AI Act jette au feu la protection du RGPD.
Cet article montre comment les praticiens de Data Vault peuvent s’adapter lorsque deux règles contraignantes entrent en collision :
l’article 9 du RGPD et l’article 10 de l’AI Act.

2
Page 3
1. Établir le système, l’acteur et la finalité
Un même entrepôt peut servir plusieurs systèmes d’IA aux finalités, aux utilisateurs et aux obligations
juridiques. Ses contrôles doivent distinguer ces usages. Partez du système ou du modèle, du
rôle de l’organisation, des données concernées et de la décision qu’elles étayeront. Une étiquette valable pour toute la
plateforme, du type « conforme à l’AI Act », laisse ces questions sans réponse.

1.1 Déterminer les obligations applicables
Une obligation d’examiner les biais peut faire naître un besoin d’informations sur les groupes sans en autoriser
l’accès. L’article 10 impose des obligations en matière de données liées aux biais pour les systèmes à haut risque concernés ;
l’article 4a encadre l’utilisation exceptionnelle de catégories particulières de données à caractère personnel pour ce travail.
Le règlement (UE) 2026/1744 a déplacé l’ancienne dérogation de l’article 10(5) vers l’article 4a
et en a étendu la portée. La modification est entrée en vigueur le 27 juillet 2026.1,2,3
L’article 4a(2) s’étend aussi aux déployeurs de systèmes à haut risque, ainsi qu’aux fournisseurs et aux déployeurs des
autres systèmes et modèles d’IA, sous réserve de ses conditions. Il autorise les traitements qui y satisfont
mais ne crée aucune obligation de procéder à ces tests de biais. Le registre de traitement doit donc
distinguer une obligation applicable d’un audit facultatif : tous deux exigent un fondement licite,
mais ils partent de positions juridiques différentes.4,5,6,7
Les dates d’adoption et d’application peuvent différer. L’article 4a est déjà utilisable, sous réserve de ses
conditions ; les obligations de l’article 10 suivent le calendrier applicable aux systèmes à haut risque : le 2
décembre 2027 pour les systèmes classés au titre de l’article 6(2) et le 2 août 2028 pour ceux
relevant de l’article 6(1), sous réserve d’exclusions et de dispositions transitoires. L’article 2(2) limite le
régime applicable aux systèmes liés aux produits de l’annexe I, section B. D’autres dispositions de l’AI Act ont
leur propre calendrier.8,9,10
Faites consigner par le responsable produit ou conformité, après revue juridique, l’acteur, le système,
la disposition applicable et sa date, la finalité du jeu de données ou du traitement, ainsi que le responsable du
contrôle qui en découle. Laissez ouvertes dans ce registre les questions non résolues. Une échéance de livraison
ne saurait les trancher.
Test. Rattachez un flux de données à son système, à sa finalité, à son responsable désigné et à la décision
décision. Si le seul fondement consigné est le souhait d’un modèle plus équitable, arrêtez-vous : cet objectif à lui seul
ne permet pas de traiter des catégories particulières de données.
L’analyse ci-dessous suppose un traitement régi par le RGPD. Les institutions de l’UE et les autorités répressives peuvent relever d’autres instruments de protection des données. Les obligations plus larges
relatives au système, reprises dans la cartographie, conservent aussi leurs propres conditions d’acteur, de champ et de
transition. L’analyse se limite aux exigences relatives aux données retenues et à leurs
interfaces organisationnelles.

3
Page 4
1.2 Suivre les données dans un modèle de recrutement
Prenons un fournisseur qui prépare un modèle de présélection de candidats et un audit des
entre les groupes. Avant de collecter ou de lire un attribut protégé, il doit
trancher la classification du système, les dates applicables, les fondements juridiques et les garanties. L’
exemple suppose que ces questions font l’objet d’une évaluation distincte ; il n’attribue aucun statut
juridique à un système réel. Les responsabilités de l’employeur interviennent là où il maîtrise les données d’entrée,
l’usage du système ou les journaux conservés.
Dans Data Vault 2.x, un hub contient des clés métier, un link représente des relations et un
satellite contient l’historique descriptif horodaté. Le Raw Vault conserve les données
reçues ; le Business Vault ajoute des règles dérivées et des aides à la requête ; l’AI-Mart fournit des
données soigneusement préparées pour le modèle. Ces structures offrent une architecture concrète. D’autres entrepôts
et lakehouses peuvent mettre en œuvre les mêmes contrôles avec d’autres composants.
Le travail va de l’autorisation et de la collecte aux contrôles de qualité, à la mise à disposition,
les preuves et l’effacement. Cet ordre de construction suit des dépendances techniques ; l’AI Act ne le
prescrit pas. L’annexe présente l’historique législatif et les controverses d’interprétation lorsque les
lecteurs ont besoin de l’argumentation juridique complète.

2. Faire correspondre les obligations aux contrôles et aux preuves
Chaque ligne relie une exigence légale retenue à un contrôle possible et aux preuves
nécessaires pour le vérifier. Certains contrôles portent directement sur les données ; d’autres alimentent
la documentation, le contrôle humain ou la surveillance ailleurs dans l’organisation. Appliquez les conditions d’acteur,
de champ et de calendrier avant d’adopter une ligne. Les composants nommés sont des choix
de conception, non des spécifications légales.

4
Page 5
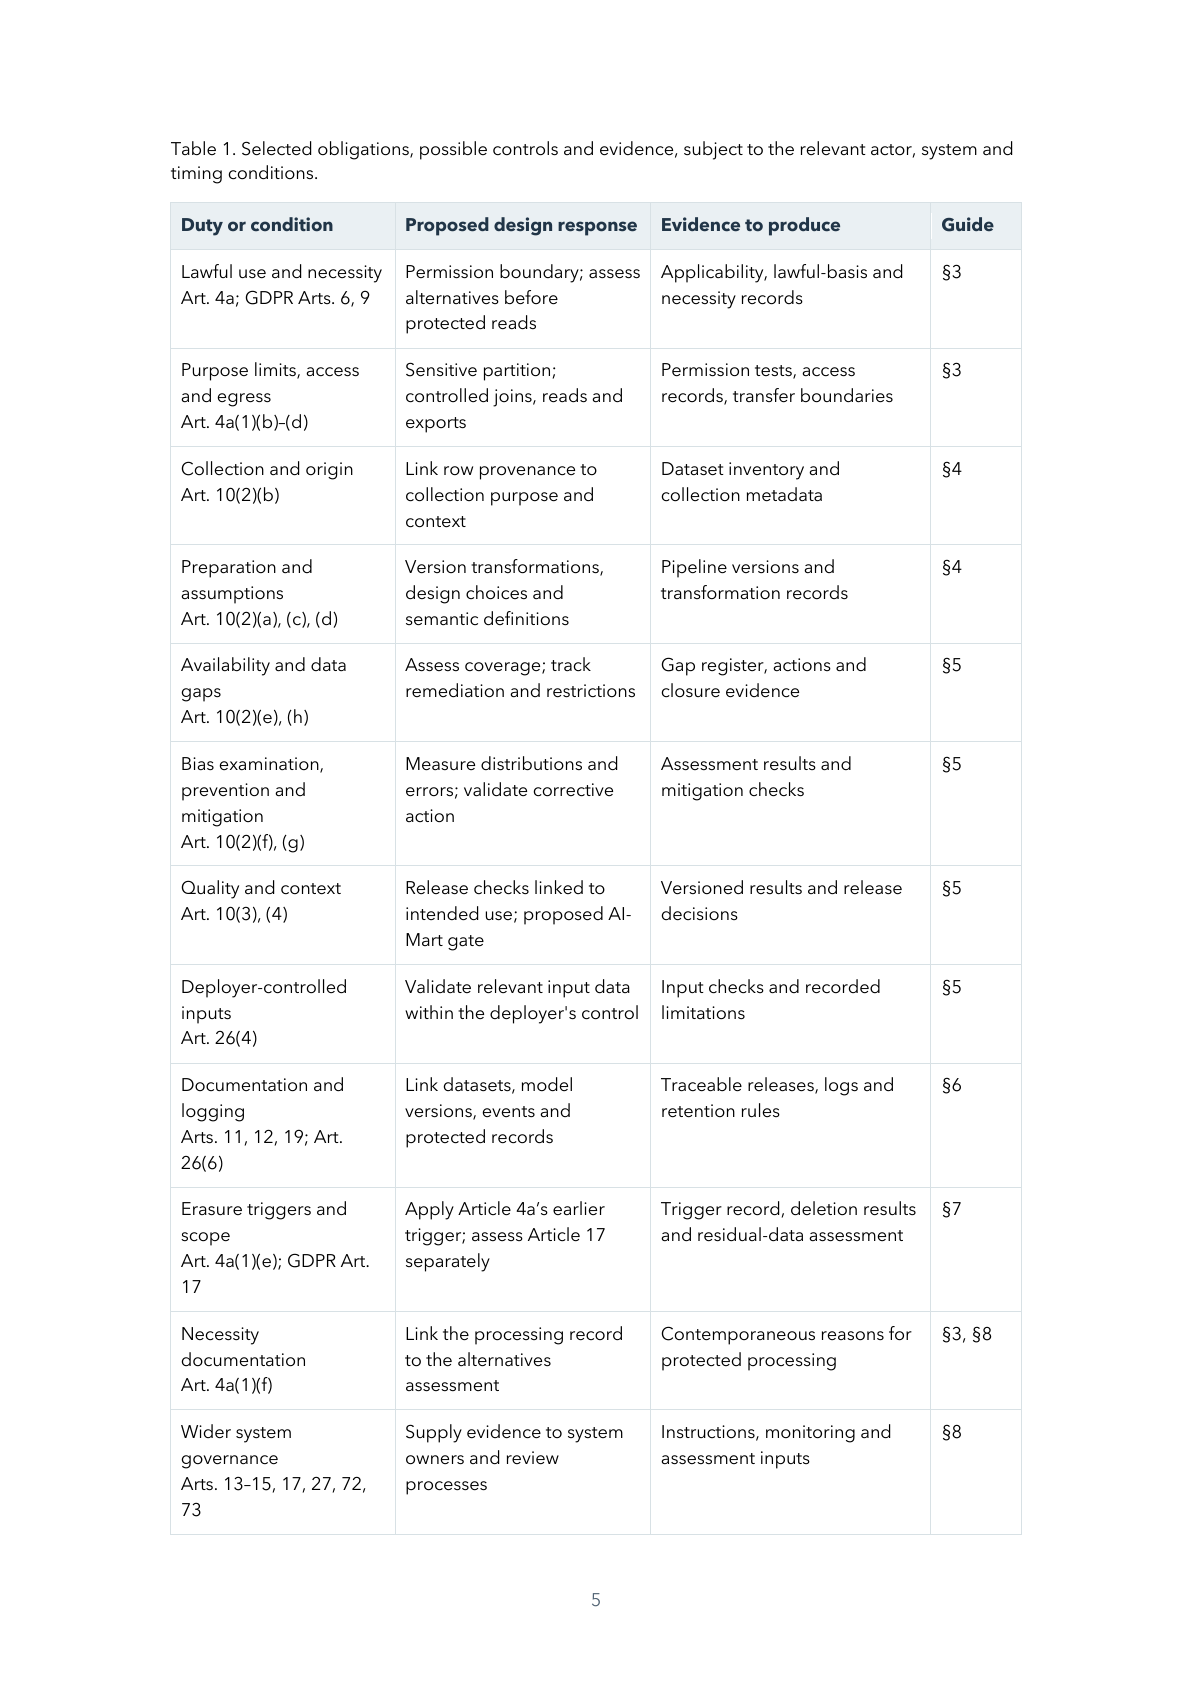
Tableau 1. Obligations retenues, contrôles possibles et preuves, sous réserve des conditions relatives à l’acteur, au système et
de calendrier applicables.
Obligation ou condition

Réponse de conception proposée

Preuves à produire

Guide

Licéité et nécessité
Art. 4a ; RGPD, art. 6 et 9

Périmètre d’autorisation ; évaluer les
alternatives avant les
toute lecture protégée

Applicabilité, base légale et
registres de nécessité

§3

Limites de finalité, accès
et sorties
Art. 4a(1)(b)–(d)

Partition sensible ;
jointures, lectures et
exports contrôlés

Tests d’autorisation, registres d’accès,
registres, limites de transfert

§3

Collecte et origine
Art. 10(2)(b)

Relier la provenance des lignes à la
la finalité de collecte et au
contexte

Inventaire des jeux de données et
métadonnées de collecte

§4

Préparation et
hypothèses
Art. 10(2)(a), (c), (d)

Versionner les transformations,
des choix de conception et
des définitions sémantiques

Versions du pipeline et
registres de transformation

§4

Disponibilité des données et
lacunes
Art. 10(2)(e), (h)

Évaluer la couverture ; suivre
les mesures correctives et les restrictions

Registre des lacunes, actions et
preuves de clôture

§5

Examen des biais,
prévention et
atténuation
Art. 10(2)(f), (g)

Mesurer les distributions et
les erreurs ; valider l’action
corrective

Résultats d’évaluation et
contrôles d’atténuation

§5

Qualité et contexte
Art. 10(3), (4)

Contrôles de mise à disposition liés à
l’usage prévu ; point de contrôle AI-Mart proposé

Résultats versionnés et décisions de mise à disposition
décisions

§5

Côté déployeur :
entrées
Art. 26(4)

Valider les données d’entrée pertinentes
relevant du déployeur

Contrôles des entrées et limites
limites consignées

§5

Documentation et
journalisation
Art. 11, 12, 19 ; art.
26(6)

Relier les jeux de données, les
versions de modèle, événements et
enregistrements protégés

Mises à disposition traçables, journaux et
règles de conservation

§6

Déclencheurs d’effacement et
périmètre
Art. 4a(1)(e) ; RGPD, art.
17

Appliquer, pour l’article 4a, le premier
déclencheur ; évaluer l’article 17
séparément

Registre des déclencheurs, résultats de suppression
et évaluation des données résiduelles

§7

Nécessité
documentation
Art. 4a(1)(f)

Relier le registre des traitements
à l’évaluation des
alternatives

Justifications contemporaines du
le traitement protégé

§3, §8

Gouvernance du système
gouvernance
Art. 13–15, 17, 27, 72,
73

Fournir des preuves aux responsables du système
responsables et aux processus
de revue

Notice d’utilisation, surveillance et
éléments d’évaluation

§8

5
Page 6
L’article 10 va bien au-delà de la seule mesure des biais. Il couvre les choix de conception,
la collecte, la préparation, les hypothèses, la disponibilité et l’adéquation des données, l’atténuation, ainsi que
les lacunes et leur traitement. Pour les systèmes à haut risque qui ne sont pas développés au moyen de techniques d’entraînement
de modèles, l’article 10(6) applique les exigences précisées aux jeux de données de test.
Consignez le type de jeu de données afin que les exigences correspondantes s’y appliquent.11
Le jeu de données d’entraînement du fournisseur et les dossiers de candidats réels de l’employeur relèvent de
responsabilités différentes. L’article 26(4) impose aux déployeurs de veiller à ce que les données d’entrée soient pertinentes et
suffisamment représentatives, dans la mesure où ils maîtrisent ces données. L’employeur
a donc besoin de contrôles des entrées dans son périmètre ; le fournisseur reste responsable de ses
propres obligations au titre de l’article 10.12

2.1 Placer les contrôles dans l’architecture
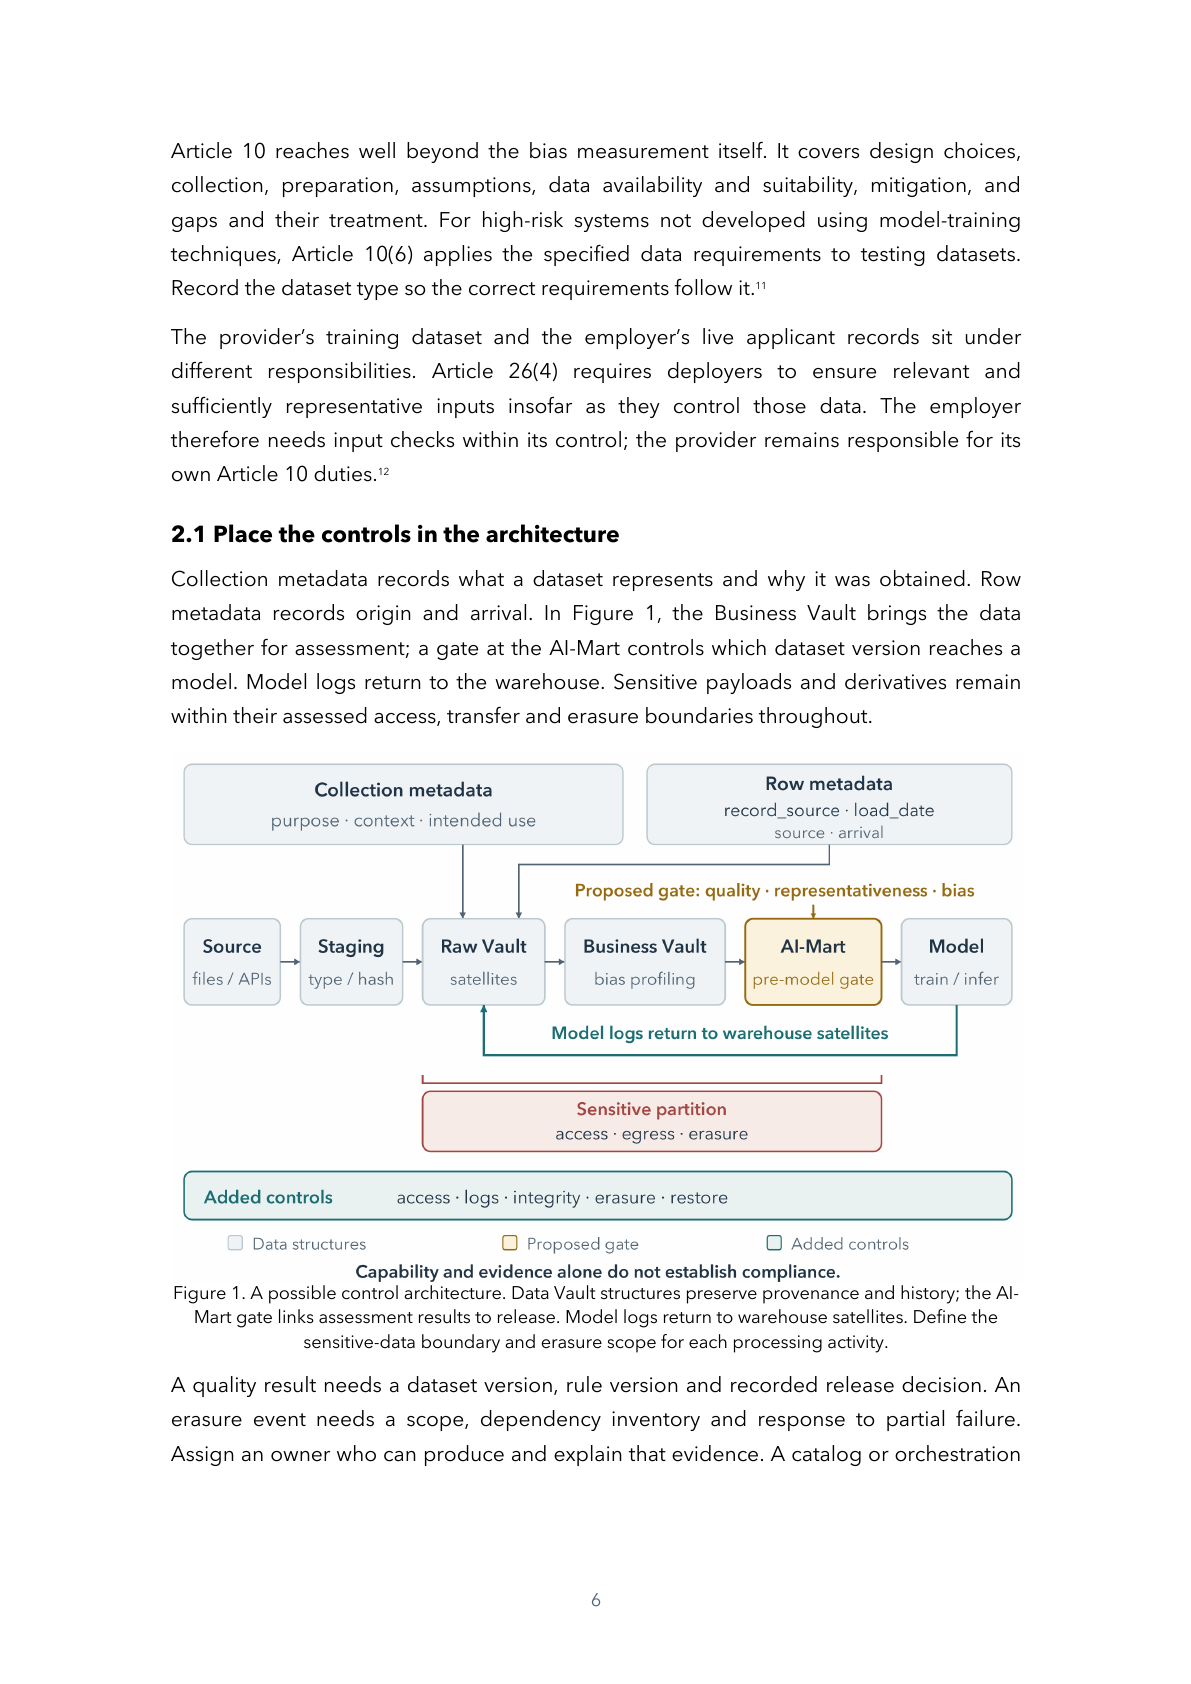
Les métadonnées de collecte consignent ce que représente un jeu de données et pourquoi il a été obtenu. Les métadonnées de ligne
métadonnées de ligne consignent l’origine et l’arrivée. Dans la figure 1, le Business Vault réunit les données
en vue de l’évaluation ; un point de contrôle à l’AI-Mart détermine quelle version du jeu de données parvient à un
modèle. Les journaux du modèle reviennent dans l’entrepôt. Les contenus sensibles et leurs dérivés restent
à l’intérieur de leurs limites évaluées d’accès, de transfert et d’effacement, de bout en bout.

Figure 1. Une architecture de contrôle possible. Les structures Data Vault préservent la provenance et l’historique ; le point de contrôle de l’AI-Mart relie les résultats d’évaluation à la mise à disposition. Les journaux du modèle reviennent dans les satellites de l’entrepôt. Définissez le
périmètre des données sensibles et le champ d’effacement pour chaque activité de traitement.

Un résultat de qualité exige une version du jeu de données, une version de règle et une décision de mise à disposition consignée. Un
événement d’effacement exige un périmètre, un inventaire des dépendances et une réponse en cas d’échec partiel.
Désignez un responsable capable de produire et d’expliquer ces preuves. Un catalogue ou un

6
Page 7
peut les conserver ; un nouveau hub ou satellite n’est utile que si le besoin de modélisation
le justifie.

3. Établir l’autorisation et définir le périmètre sensible
Un audit de recrutement qui compare les résultats de sélection peut nécessiter des données révélant l’origine ethnique.
Ces données relèvent de l’article 9 du RGPD : les collecter ou les utiliser constitue un traitement, même si le
rapport ne contient que des statistiques.13 Avant de choisir des tables ou de lancer des requêtes, établissez la
finalité, les enregistrements et les utilisateurs autorisés. Une consigne du type « vérifier l’équité » laisse ces
décisions en suspens.

3.1 Établir la base légale
Le traitement de catégories particulières de données exige à la fois une base légale au titre de l’article 6 et une exception relevant de l’article 9
exception.14 L’article 4a s’applique parallèlement au RGPD et n’identifie pas le
fondement retenu par l’organisation au titre de l’article 6.15,16,17 Le responsable du traitement, assisté de ses conseils, doit
expliquer pourquoi chaque voie couvre l’acteur et l’activité. Si les fondements nécessaires ou les conditions de l’article
4a ne peuvent être établies, le traitement des données sensibles ne doit pas avoir lieu ;
les garanties techniques ne peuvent pallier l’absence de fondement.18
L’article 6(1)(c) peut fonder un traitement nécessaire au respect d’une obligation applicable de l’article
10 relative aux biais.19 Un responsable du traitement du secteur privé éligible qui envisage l’article 6(1)(f)
doit établir que l’intérêt est licite, que le traitement est nécessaire et que les
intérêts ou les libertés et droits fondamentaux de la personne ne prévalent pas.20 Les
autorités publiques ont besoin d’une autre base de l’article 6 pour les traitements effectués dans l’exécution de
leurs missions publiques.14 Consignez si les tests remplissent une obligation ou sont volontaires : l’article 4a(2)
ne crée pas, à lui seul, d’obligation de tester.5

3.2 Évaluer les alternatives avant de lire des enregistrements protégés
La condition (a) exige une conclusion étayée selon laquelle d’autres données, y compris des données synthétiques ou
anonymisées, ne peuvent atteindre efficacement l’objectif ; la condition (f) exige que la justification de la stricte nécessité figure dans les registres des activités de traitement.21,22 Définissez la
comparaison envisagée et évaluez les résultats déjà anonymes, les données synthétiques adaptées et les autres
sources licites par ailleurs. Consignez ce que chacune permet d’établir et où elle s’arrête. Une
comparaison contrôlée peut aider, mais le droit n’impose ni une expérience unique ni une
séquence exhaustive de techniques. Les enregistrements protégés ne peuvent être lus pour cette
évaluation avant que l’autorisation et les garanties ne soient établies.
Les taux de sélection globaux peuvent masquer des différences entre groupes. Un proxy fondé sur le code postal peut
manquer de fiabilité, révéler lui-même l’origine ethnique et nécessiter l’attribut protégé pour sa
validation.23,24 Calculer un agrégat anonyme à partir d’enregistrements protégés identifiables
reste un traitement au niveau des enregistrements. Un tiers détenant ces enregistrements déplace la
question de l’article 9 et peut entrer en conflit avec la restriction, posée par l’article 4a, de l’accès par d’autres parties.25,26

7
Page 8
Utilisez des alternatives suffisantes dans leur cadre licite ; à défaut, documentez leurs limites
avant d’autoriser le traitement de données sensibles.

3.3 Définir ce qui peut entrer dans l’entrepôt
L’origine ethnique peut figurer dans un satellite sensible* dédié, lié aux enregistrements des personnes concernées par l’audit,
l’accès aux informations identifiantes étant contrôlé séparément. Une partition propre à la campagne
constitue une autre option. Choisissez les périmètres en fonction de l’usage autorisé et de ce qui
doit être effacé ensemble. Le responsable du traitement et l’ingénieur data devraient consigner la finalité,
les versions du jeu de données et du modèle, les attributs nécessaires, les utilisateurs autorisés, les destinations,
le délai de conservation et l’unité de suppression. Hacher la clé métier ne rend pas
anonymes les enregistrements associés lorsque l’identification reste possible.27
Les six conditions de l’article 4a doivent toutes être remplies, garanties en place, avant que le traitement
ne commence. La condition (b) exige des limites techniques à la réutilisation ainsi que des mesures de sécurité et
de protection de la vie privée à l’état de l’art, dont la pseudonymisation ; la condition (c) exige des
des contrôles d’accès, des obligations de confidentialité et une documentation des accès ; la condition (d)
interdit la transmission, le transfert ou l’accès par d’autres parties. La notion d’« autres parties » doit faire
l’objet d’une évaluation propre au montage retenu ; elle ne se réduit pas à « aucun partage non autorisé ».28,29,26
Le responsable de la plateforme doit tester les autorisations des satellites et les flux sortants ; le responsable
responsable devrait vérifier les champs et les jointures au regard de la finalité approuvée. Appuyez-vous sur de vraies requêtes pour
établir que les contrôles tiennent.
La condition (e) impose la suppression dès la première des deux échéances : correction des biais ou expiration de la durée de conservation.30
Avant le premier chargement sensible, définissez l’événement de correction et un parcours d’effacement couvrant les
les données dépendantes et les processus de restauration. Le responsable du traitement porte l’autorisation et le
registre de nécessité ; les responsables de l’ingénierie apportent la preuve que les contrôles fonctionnent.
Test. À l’aide de données de test non personnelles, tentez des chargements distincts avec une référence d’autorisation manquante
référence, un attribut non approuvé et un périmètre d’effacement non défini. Chacun devrait être
refusé et consigné. Exécutez un chargement autorisé et vérifiez que seuls les rôles habilités peuvent
l’interroger. Consignez la configuration et les responsables ; des tests réussis sur données fictives n’établissent pas
la licéité du traitement.

*

« Satellite sensible » est une expression descriptive, non un terme technique consacré. Le vocabulaire publié par les praticiens (Linstedt ;
Scalefree, n 54) parle de « satellite split », c’est-à-dire de la scission entre un satellite de données personnelles et un satellite non personnel. Le terme « PII satellite »
est aussi courant, mais « PII » relève du vocabulaire américain (NIST) et désigne toutes les données personnelles, noms et
adresses comprises. « Sensible » a ici un sens plus étroit : il désigne uniquement les catégories particulières de l’article 9 du RGPD,
telles que l’origine ethnique ou la religion. Dans le vocabulaire de l’UE, la formulation la plus sûre est « satellite de catégorie particulière ».

8
Page 9
Figure 2. Évaluer d’abord les autres données. Établir la base de l’article 6 et les six conditions de l’article 4a avant de
traiter des enregistrements protégés ; effacer au premier déclencheur atteint et ne conserver que des résultats anonymes ou
détenus licitement à un autre titre.

4. Consigner la provenance, la finalité et l’historique des transformations
Pour les fournisseurs dont les données d’entraînement, de validation et de test relèvent de l’article 10, l’article
10(2)(b) couvre les processus de collecte et l’origine des données, y compris la finalité d’origine de la
la collecte des données personnelles.31 Un examinateur doit pouvoir suivre le jeu de données de sa collecte jusqu’à
son usage par le modèle et comprendre ce que représentent les enregistrements. Data Vault peut contenir ces
preuves ; c’est à l’équipe de les fournir.

4.1 Consigner pourquoi et où les données ont été collectées
Les champs de ligne record_source et load_date identifient la source et l’arrivée, pas la finalité ni le
contexte. « Système de candidatures » et un horodatage n’identifient ni la campagne de recrutement,
ni la finalité de collecte d’origine, ni la zone géographique ou la population couverte. Reliez le chargement à un
registre de collecte contenant ces faits et leurs pièces justificatives. Le responsable des données
devrait vérifier la description de la collecte ; l’ingénieur devrait préserver le lien
entre les lignes chargées et la bonne version de ce registre.
Les informations de collecte peuvent résider dans les métadonnées du catalogue, dans une structure de référence ou dans un satellite
qui enregistre les modifications de la finalité documentée. Conservez les versions antérieures afin qu’une nouvelle
description ne réécrive pas l’explication rattachée à un ancien extrait. L’article 10(2)(d)
exige aussi de formuler des hypothèses sur ce que les données mesurent et représentent.32 Définissez si
un résultat manquant signifie « pas encore décidé » ou « non retenu » ; le seul nom de la colonne
ne permet pas de les distinguer.

9
Page 10
Consignez les choix de conception pertinents à côté des faits sources.11 Expliquez pourquoi l’audit compte les
des candidatures plutôt que des personnes ou des postes, et pourquoi le résultat retenu représente
la tâche prévue du modèle. Reliez ces décisions aux registres de collecte et aux registres sémantiques. Une
requête reproductible peut encore mesurer la mauvaise chose si son unité d’analyse est mal
choisie ou non documentée.

4.2 Tracer chaque transformation
Documentez comment les candidatures ont été rapprochées des résultats, comment les doublons ont été traités et
étiquettes de résultat dérivées. L’article 10(2)(c) couvre les opérations de préparation, notamment
l’annotation, l’étiquetage, le nettoyage, la mise à jour, l’enrichissement et l’agrégation.33 Le Raw Vault
peut conserver l’historique reçu, le Business Vault les règles dérivées, et le mart livrer les
extraits destinés au modèle. Pour retracer un résultat à travers ces couches, le pipeline doit consigner quelle
règle et quelle exécution l’ont produit.
Un extrait mis à disposition doit renvoyer à ses collectes sources, aux versions de transformation,
à ses registres d’exécution et à ses définitions sémantiques. Le responsable de l’ingénierie des données devrait
entretenir cet historique au moyen des journaux d’orchestration, du code versionné et des entrées
du catalogue. Les références doivent identifier les versions effectivement utilisées. Pour les modifications manuelles
des étiquettes ou des correspondances, consignez le motif et le responsable désigné.
Un journal de transformation n’a pas besoin de copier des valeurs protégées pour prouver qu’une règle a été exécutée. Les données de diagnostic
les données de diagnostic qui en contiennent exigent des contrôles d’accès et une couverture par l’effacement. Conservez la
méthode, les décisions et les résultats autorisés, tout en reconnaissant qu’ils ne peuvent servir à
des recalculs indéfinis une fois les enregistrements protégés sous-jacents licitement
supprimés.
Test. Remontez d’un champ transformé, dans un extrait mis à disposition, jusqu’à son registre de collecte et à la version exacte
de transformation. Demandez à un examinateur autre que l’auteur du pipeline d’en expliquer la
finalité, le sens des valeurs manquantes et la dérivation. Après avoir modifié une règle de correspondance, vérifiez
que l’ancien extrait renvoie toujours à l’ancienne règle et que le nouvel extrait identifie la
modification.

5. Mesurer la qualité des données et les biais, puis contrôler la mise à disposition
Pour les fournisseurs soumis à l’article 10, les jeux de données doivent être pertinents, suffisamment représentatifs,
présenter des propriétés statistiques appropriées et être aussi complets et exempts d’erreurs que possible.
Le règlement exige aussi l’examen de biais déterminés et des mesures appropriées pour les
les détecter, les prévenir et les atténuer.34,6 Fixez et justifiez des critères d’évaluation pour l’usage
prévu, calculez les preuves et bloquez les extraits inadaptés. Ces obligations ne fournissent aucun
seuil d’acceptation universel.

10
Page 11
5.1 Définir la population et les mesures
Un jeu de données correctement chargé peut couvrir la mauvaise région, la mauvaise période ou le mauvais processus de recrutement.
Les responsables du modèle et des données doivent définir la population, le cadre et les
résultats visés. L’article 10(4) vise le cadre géographique, contextuel, comportemental et
fonctionnel d’utilisation.35 Les contrôles peuvent porter sur les résultats manquants, les candidatures en double,
la couverture de la population et les écarts pertinents de taux de sélection ou d’erreur. Consignez leurs
tolérances, leur justification et le traitement de l’incertitude. Un seuil chiffré applicable techniquement n’est pas
pour autant juridiquement suffisant.
L’article 10(2) exige d’évaluer la disponibilité, la quantité et l’adéquation des données, ainsi que
l’identification des lacunes ou insuffisances pertinentes et de la manière d’y remédier.11 Nommez
les populations manquantes ou les étiquettes peu fiables, expliquez leur effet sur l’usage prévu et désignez
un responsable à la réponse. Davantage de lignes issues de la même source inadaptée ne comblent pas forcément la
lacune. Reportez les limites non résolues dans la décision de mise à disposition.
Les résultats au niveau des groupes peuvent révéler une disparité sans montrer comment la corriger.
La repondération, le réétiquetage ou une collecte ciblée peuvent exiger des liens au niveau des enregistrements entre les
les attributs protégés, les entrées du modèle et les résultats. L’autorisation d’une comparaison statistique
ne couvre pas automatiquement ces opérations. Le responsable du modèle devrait expliquer ce que
les mesures effectuées établissent, ce qui reste incertain et si la correction exige une
nouvelle décision de traitement. Consignez les mesures employées pour détecter, prévenir et atténuer
les biais identifiés, leurs responsables et les preuves de leurs effets.11

5.2 Faire dépendre la mise à disposition de l’évaluation
Le Business Vault peut contenir des données intégrées et des requêtes qui mesurent la couverture, la qualité
et les biais. Un point de contrôle à l’AI-Mart peut retenir les extraits qui échouent aux contrôles convenus. Les travaux de praticiens
décrivent l’AI-Mart comme un emplacement pour des données d’entraînement préparées et validées ; l’AI Act
n’exige aucune couche ainsi nommée.36 Un service d’export ou un pipeline d’entraînement peut appliquer
la même décision. L’évaluation doit régir la voie qui alimente effectivement le
modèle.
Le registre de mise à disposition doit identifier les versions du jeu de données et du modèle, les résultats d’évaluation,
les limites non résolues et le responsable de la décision. L’ingénierie fournit les preuves
d’exécution ; le responsable du modèle explique les conséquences pour l’usage prévu. Une tâche
terminée ne peut tenir lieu d’une évaluation absente ou en échec. Lorsqu’une exception est admise,
documentez-la et maintenez-la dans le cadre des exigences applicables et du périmètre approuvé. Une
dérogation ne peut rendre licite un traitement illicite.

5.3 Vérifier séparément les données d’entrée contrôlées par le déployeur
Un employeur peut contrôler les dossiers de candidats fournis au système de recrutement tandis que
le fournisseur maîtrise son jeu de données d’entraînement. L’article 26(4) exige des données d’entrée pertinentes et suffisamment
représentatives dans la mesure où le déployeur les maîtrise.12 Le responsable des données de l’employeur

11
Page 12
devrait identifier cette frontière, appliquer les spécifications d’entrée du fournisseur et évaluer
si les enregistrements correspondent au cadre de recrutement prévu. Cette responsabilité est distincte
du programme de données d’entraînement du fournisseur.
Pour chaque lot d’entrée, consignez sa source, les champs attendus, les contrôles de qualité et de couverture,
ses limites connues et l’examinateur responsable. Testez un lot incomplet ou hors périmètre
avant qu’il n’atteigne la voie d’entrée en production. Le processus doit le retenir ou le rejeter, en consigner le
motif et faire remonter le problème au responsable du système. Les contrôles de schéma ne suffisent pas à établir
la représentativité ; les déployeurs ne devraient revendiquer ni maîtrise ni preuves sur des données qu’ils
ne peuvent pas examiner.

5.4 Évaluer ce qui peut être conservé
Les petits groupes et les requêtes qui se recoupent peuvent révéler l’appartenance à un groupe, des attributs cachés ou des
des enregistrements individuels. Les données agrégées ne sont pas anonymes par nature.37 La suppression de cellules,
les tailles minimales de groupe et le bruit de confidentialité différentielle peuvent réduire le risque de divulgation tout en
affaiblissant le signal de l’audit. Paramétrez-les en fonction du cas d’usage et du critère du RGPD consistant à savoir
si l’identification reste raisonnablement probable ; il n’existe pas de taille de cellule « sûre » universelle.27
Le responsable concerné doit consigner l’évaluation du risque de divulgation et son effet sur les
conclusions.
Les satellites calculés du Business Vault peuvent conserver des résultats d’audit licites liés à une exécution d’audit
exécution d’audit ou à une version de modèle.38 Ces résultats doivent toujours être suffisamment anonymes ou reposer sur une autre base licite.
Ils ne peuvent pas servir de base à toute mesure future une fois les enregistrements protégés supprimés.
Consignez cette limite, la méthode et les preuves à l’appui qui peuvent subsister.
Test. Introduisez un défaut de qualité connu dans un extrait de test non personnel. Séparément, omettez son
résultat d’évaluation. Vérifiez que les deux tentatives sont refusées sur la voie d’entrée du modèle et
produisent des registres d’échec exploitables. Testez, dans le rapport, les contrôles portant sur les petits groupes et les requêtes
qui se recoupent, et vérifiez que son interprétation tient compte de toute suppression ou de tout bruit.

6. Relier les jeux de données, l’utilisation du modèle et les preuves
6.1 Rendre chaque livraison traçable
Pour chaque modèle de recrutement mis à disposition, conservez une trace de la version du jeu de données, des modifications
qui y ont été apportées et les décisions autorisant son usage.
Les hubs contiennent les identifiants métier, les links représentent les relations et les satellites préservent
l’historique descriptif. Les chargements ordinaires de satellites ajoutent des lignes, ce qui permet de constituer un système de référence
historique et le chargement en parallèle ; une suppression contrôlée reste techniquement possible.39,40,41 Attribuez
à chaque version de jeu de données, version de modèle et campagne de revue des biais un identifiant stable.
Reliez-les par des links et rattachez les décisions, transformations et
résultats pertinents au moyen de satellites.

12
Page 13
Le responsable de l’ingénierie des données doit pouvoir retracer une livraison depuis sa source et son
son contexte de collecte, en passant par la préparation, les mesures du Business Vault et, dans l’AI-Mart, la
décision de mise à disposition, jusqu’à la version du modèle destinataire. Rattachez à la campagne la finalité approuvée et
la règle de conservation ; record_source et load_date ne les véhiculent pas.
Consignez la version de transformation et les contrôles qui ont validé l’extrait. Conservez suffisamment
d’informations de version pour expliquer un résultat historique sans conserver de valeurs protégées
au-delà de leur date de suppression licite.
Test. Demandez à un relecteur qui n’a pas construit le pipeline d’identifier le jeu de données d’une version de modèle,
ses règles de transformation, ses résultats de contrôle et sa décision de mise à disposition. Changez la version du jeu de données ou
faites échouer un contrôle de mise à disposition : la trace doit distinguer la nouvelle tentative, et l’extrait en échec
ne doit pas atteindre le modèle. Ces tests n’établissent pas que les métriques ou les seuils
satisfont aux exigences du droit.

6.2 Contrôler les journaux du modèle
Lorsque l’article 12 s’applique, les systèmes à haut risque doivent permettre l’enregistrement automatique des événements
tout au long de leur cycle de vie.42 Les paragraphes 1 et 2 posent les exigences générales ;
la liste détaillée du paragraphe 3 s’applique à certains systèmes biométriques.43 Choisissez les champs en fonction des
exigences applicables. La capacité de journalisation sur tout le cycle de vie n’impose pas de conserver pendant toute sa durée
chaque événement : évaluez la conservation séparément.
Les journaux d’entraînement et d’inférence peuvent revenir dans l’entrepôt sous forme de satellites liés à l’exécution ou à la
version du modèle, selon la pratique Data Vault publiée.44 Sélectionnez les preuves utiles —
le cas échéant entrées, transformations, paramètres, sorties et scores de confiance — sans
copier chaque entrée dans un journal permanent. Les responsables du modèle et de la plateforme devraient s’accorder sur
le sens des événements, les restrictions d’accès et la conservation. Omettez les valeurs sensibles lorsque la
finalité de journalisation peut être atteinte sans elles ; sinon, incluez ces satellites de journaux dans le
périmètre sensible et le plan d’effacement.
La piste d’audit d’un système source n’établit pas qui a interrogé l’entrepôt. Les satellites de suivi de statut
satellites de suivi de statut peuvent conserver les événements de création, de lecture, de mise à jour et de suppression fournis par la source ;
les journaux de requêtes et d’accès de l’entrepôt décrivent une autre frontière. Vérifiez que les preuves
retenues identifient l’utilisateur, l’opération et le périmètre de données concernés sans
copier inutilement des valeurs protégées.45
Un opérateur disposant de privilèges peut modifier l’historique malgré un chargement en ajout seul. Protégez les journaux de modification
et d’accès, restreignez les droits de modification et prévoyez des contrôles d’intégrité appropriés.
Consignez l’effacement autorisé sans préserver les données supprimées. Testez à la fois une
modification interdite et un effacement autorisé : la première doit être bloquée ou
détectée, tandis que le second doit laisser les preuves restantes exploitables.
L’article 19(1) confie au fournisseur la conservation des journaux qu’il contrôle ; l’article 26(6)
vise le déployeur. Chacun impose une durée adaptée à la finalité d’au moins six

13
Page 14
mois, sauf disposition contraire du droit applicable, notamment du droit de la protection des données.46
Identifiez quels journaux de fonctionnement du modèle le fournisseur du modèle de recrutement contrôle et quels
journaux d’utilisation relèvent de l’employeur. Distinguez les preuves opérationnelles ordinaires des
contenus protégés soumis au périmètre d’effacement évalué.

6.3 Conserver les preuves de manière licite
Un satellite calculé peut conserver un résultat licite, sa méthode, l’identifiant de campagne et le
registre de décision après la suppression.38 De petits groupes ou des résultats qui se recoupent peuvent encore exposer des
personnes : l’agrégation seule n’établit pas l’anonymat.37,27 Consignez l’évaluation d’anonymat
ou l’autre base licite de conservation, ainsi que les limites qui en découlent pour un nouvel audit. Un
résultat d’écart de recrutement enregistré ne peut recréer les enregistrements supprimés pour chaque métrique ultérieure
ou version de modèle.

7. Rendre la conservation et l’effacement exécutables
7.1 Relier les deux déclencheurs de suppression
L’article 4a(1)(e) impose la suppression dès la première des deux échéances : la correction des biais ou l’expiration de la durée de conservation.47 Un
ordonnanceur peut détecter une échéance, mais ne peut pas décider que le biais a été corrigé. Le
responsable du modèle et la fonction juridique ou de gouvernance doivent définir, valider et consigner cet
état. L’ingénierie relie ensuite l’événement du cycle de vie et l’échéance de conservation à un seul
workflow d’effacement. Van Bekkum relève le lien étroit de cette condition avec le principe de
limitation de la conservation du RGPD : la décision de conservation doit être justifiée, et pas seulement assortie d’une échéance exécutable.48
Avant le chargement, définissez si la suppression porte sur une campagne, une version de modèle, une personne concernée ou un
ensemble plus restreint partageant une finalité et un déclencheur communs. Reportez ce périmètre sur les lignes de satellites,
les variables, les tables intermédiaires, les marts, les journaux, les exports et les copies récupérables. Désignez un
responsable opérationnel chargé d’achever la suppression sur l’ensemble de cet inventaire et de faire remonter les échecs.
Consignez le périmètre, le déclencheur, les composants concernés et le résultat sans copier la
valeur protégée.

7.2 Adapter le schéma à l’unité de suppression
Une table, un ensemble de lignes et une clé de chiffrement définissent des périmètres de suppression différents. Adaptez le
schéma au périmètre approuvé et au comportement de restauration.

14
Page 15
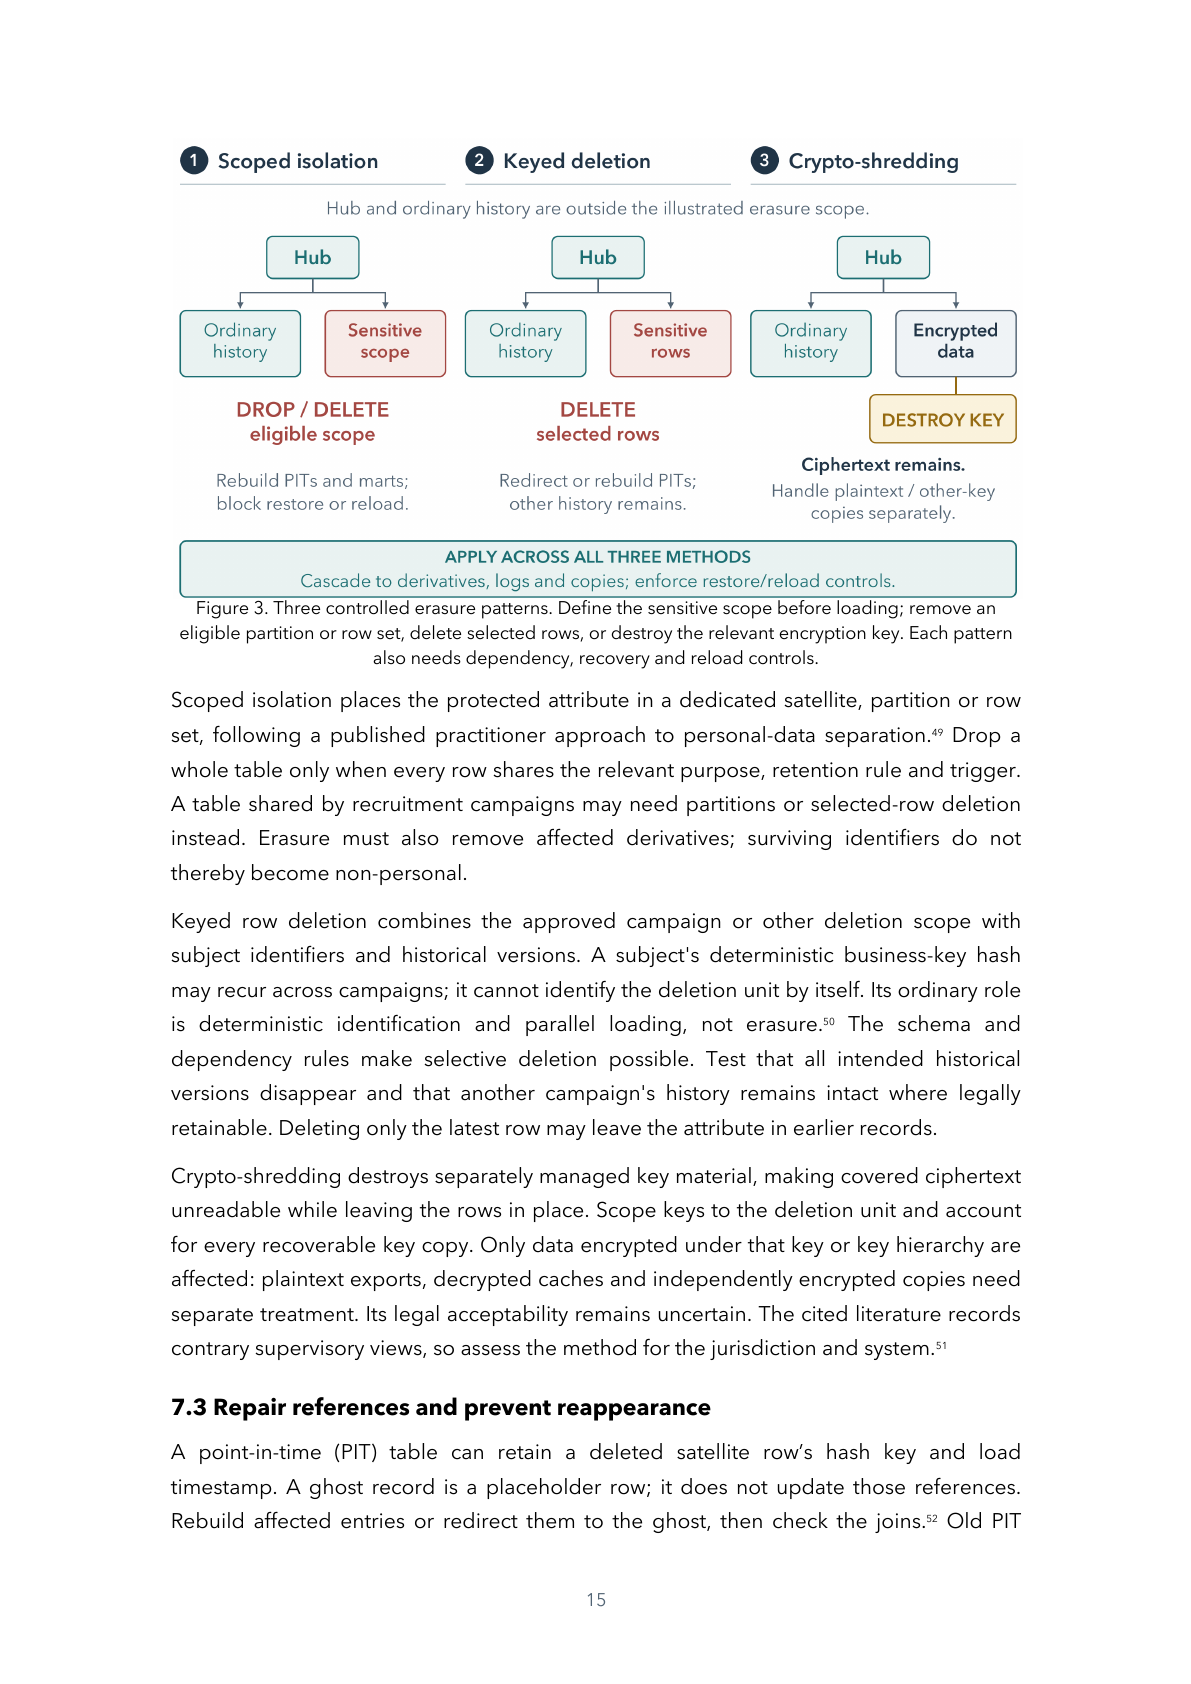
Figure 3. Trois schémas d’effacement contrôlés. Définir le périmètre sensible avant le chargement ; supprimer une
partition ou un ensemble de lignes éligible, supprimez des lignes sélectionnées, ou détruisez la clé de chiffrement concernée. Chaque schéma
nécessite aussi des contrôles des dépendances, de la reprise et du rechargement.

L’isolement circonscrit place l’attribut protégé dans un satellite, une partition ou un ensemble de lignes dédiés,
lignes dédiés, selon une approche de praticiens publiée pour séparer les données personnelles.49 Ne supprimez une
table entière que si toutes ses lignes partagent la même finalité, la même règle de conservation et le même déclencheur.
Une table partagée par plusieurs campagnes de recrutement peut nécessiter des partitions ou la suppression de lignes sélectionnées
à la place. L’effacement doit aussi supprimer les dérivés concernés ; les identifiants qui subsistent ne
deviennent pas pour autant non personnels.
La suppression de lignes par clé combine la campagne approuvée, ou tout autre périmètre de suppression, avec les
les identifiants des personnes et les versions historiques. Le hash déterministe de la clé métier d’une personne
peut se retrouver d’une campagne à l’autre ; il ne peut à lui seul identifier l’unité de suppression. Son rôle ordinaire
est l’identification déterministe et le chargement en parallèle, non l’effacement.50 Le schéma et les
règles de dépendance rendent possible une suppression sélective. Vérifiez que toutes les versions historiques visées
disparaissent et que l’historique d’une autre campagne reste intact lorsqu’il peut légalement
être conservé. Ne supprimer que la dernière ligne peut laisser l’attribut dans des enregistrements antérieurs.
Le crypto-shredding détruit des éléments de clé gérés séparément, ce qui rend le texte chiffré concerné
illisible tout en laissant les lignes en place. Alignez les clés sur l’unité de suppression et recensez
chaque copie récupérable de clé. Seules les données chiffrées sous cette clé ou cette hiérarchie de clés sont
concernées : les exports en clair, les caches déchiffrés et les copies chiffrées indépendamment nécessitent un
traitement distinct. Son acceptabilité juridique reste incertaine. La littérature citée fait état
de positions divergentes d’autorités de contrôle ; évaluez donc la méthode selon la juridiction et le système.51

7.3 Réparer les références et empêcher la réapparition
Une table point-in-time (PIT) peut conserver la clé de hachage d’une ligne de satellite supprimée et son horodatage de
chargement. Un enregistrement fantôme (ghost record) est une ligne de substitution ; il ne met pas à jour ces références.
Reconstruisez les entrées concernées ou redirigez-les vers l’enregistrement fantôme, puis vérifiez les jointures.52 Les anciens
15
Page 16
instantanés peuvent ordinairement être reconstruits à partir du Raw Vault.53 L’effacement doit empêcher la
reconstitution de la valeur protégée, et non simplement supprimer une structure de requête.
Une restauration, une nouvelle tentative ou une actualisation de la source ne doit pas rendre de nouveau disponible une valeur effacée. Appliquez
le périmètre évalué aux sauvegardes et autres copies récupérables. Un registre d’exclusion peut
coordonner cela seulement si son contenu et son usage sont appropriés ; ne conservez pas l’attribut
supprimé dans le journal de suppression. Demandez au responsable de la restauration de démontrer la procédure de
restauration avant que la campagne n’entre en production.
La suppression complète d’une campagne peut laisser sans réponse une demande fondée sur l’article 17 du RGPD. Ce
droit a ses propres motifs et exceptions et peut atteindre les identifiants de hub, les clés métier,
les liens ou d’autres satellites laissés intacts par la suppression centrée sur l’attribut prévue à l’article 4a.54 La
littérature sur le stockage résistant à l’effacement traite elle aussi l’effacement comme un problème d’architecture plus large.55
Évaluez la demande plus large au regard d’un inventaire des données à caractère personnel ; un satellite de biais vide
n’est pas un critère d’achèvement.

7.4 Trancher la conservation des journaux et les effets sur le modèle
L’article 26(6) impose aux déployeurs de conserver les journaux générés automatiquement qui sont sous leur
contrôle pendant une durée adaptée à la finalité d’au moins six mois, sauf disposition contraire du droit applicable,
notamment du droit de la protection des données.56 La clôture d’une campagne
n’autorise pas à supprimer tous les journaux opérationnels. Évaluez quelles valeurs de catégories particulières relèvent
premier déclencheur de l’article 4a, et quels autres enregistrements peuvent ou doivent subsister. Encodez ces
périmètres séparément.
Supprimer des données d’entraînement n’efface pas automatiquement leur effet sur le modèle.
La repondération, le réétiquetage ou l’échantillonnage peuvent utiliser un attribut protégé absent des
entrées finales. Le réentraînement complet est le point de référence ; les méthodes exactes et approchées de
désapprentissage diffèrent par leur coût, leurs exigences d’accès et leurs limites.57 Consignez l’influence de
l’attribut et évaluez la nécessité d’un réentraînement, d’un désapprentissage, d’un remplacement ou d’une autre
réponse documentée. La question de savoir si le modèle conserve ou expose des données personnelles exige une
évaluation au cas par cas des risques d’extraction et de requête.58 Un test de suppression dans l’entrepôt
ne peut pas répondre à cette question.

8. Tester, exploiter et transmettre les contrôles
8.1 Tester tout le parcours, y compris les défaillances
Avec des données de test adaptées, faites passer une campagne par la collecte autorisée, le profilage, la mise à disposition,
la journalisation et la suppression. Déclenchez la correction du biais avant l’échéance de conservation, puis inversez
l’ordre lors d’une exécution distincte. Vérifiez les stockages primaires et dérivés, la réparation des PIT, le traitement
de la journalisation et les résultats licitement conservés. Examinez les données et le comportement des requêtes, pas seulement le
statut des tâches.

16
Page 17
Interrompez une suppression puis relancez-la. Restaurez une copie plus ancienne selon la procédure documentée
et rejouez un chargement source ; aucune de ces opérations ne doit remettre en usage la valeur protégée.
Tentez une lecture ou un export non autorisés avec un compte ordinaire : les deux doivent être refusés.
Testez une modification privilégiée dans le cadre de contrôles convenus, en précisant si la prévention ou la
détection est réalisable, et comment signaler et corriger une altération. Détecter une
divulgation non autorisée déjà survenue ne suffit pas à réussir un test de contrôle d’accès. Consignez les échecs
et leurs responsables.

8.2 Transmettre les décisions, les preuves et les responsabilités
La passation doit couvrir l’applicabilité et la licéité du traitement ; les relations entre jeux de données et modèles
relations ; le périmètre sensible ; les contrôles de mise à disposition ; les règles d’accès et de sortie ; les champs de journal et leur
conservation ; les déclencheurs et la méthode de suppression ; la restauration et le rechargement ; les résultats des tests ; et les
questions non résolues. Désignez une fonction responsable pour chaque responsabilité opérationnelle.
L’exploitation a besoin d’un runbook pour reconnaître les déclencheurs, suivre l’avancement, se rétablir
après un échec partiel, vérifier les données restantes et faire remonter les composants non résolus.
Le responsable du modèle a besoin de la décision distincte sur les effets sur le modèle et les limites d’un nouvel audit. Remettez à la
gouvernance les résultats des tests, les échecs et les appréciations encore en suspens. Revoyez les registres lorsque
les sources, l’usage du modèle, les transformations, les règles de conservation ou les dispositifs de restauration changent.

8.3 Contribuer aux obligations plus larges du système
Transmettez au responsable de la documentation du fournisseur les versions des jeux de données, le contexte de collecte,
l’historique des transformations, les résultats de validation et les limites connues nécessaires à la documentation
technique. Reliez les procédures d’exploitation (runbooks) et les registres de revue au système de gestion de la qualité. Les articles
11, 16 et 17 exigent davantage de documentation et de procédures qu’un catalogue ne peut en fournir ;
La règle des dix ans de l’article 18 couvre la documentation énumérée, et non la conservation généralisée des
données personnelles d’entraînement.46
Fournissez les spécifications des données d’entrée et les limites de performance à l’équipe qui rédige les instructions destinées aux déployeurs
instructions d’utilisation. Fournissez aux responsables du contrôle humain des preuves intelligibles et des voies d’intervention ;
un point de contrôle automatisé de mise à disposition n’est pas un contrôle humain. Travaillez avec les équipes modèle, plateforme et
sécurité sur l’exactitude, la robustesse, les boucles de rétroaction et les risques d’empoisonnement. Ces
contributions étayent les articles 13 à 15 ; un score de qualité de l’entrepôt ne peut établir
qu’ils sont respectés.59
Après la mise à disposition, reliez les résultats de surveillance et les problèmes signalés au modèle concerné,
du jeu de données et du traitement concernées. Transmettez les signaux significatifs au responsable de la surveillance ou des
incidents, avec horodatages et preuves exploitables. Un dépassement de seuil n’est pas automatiquement un
incident grave à signaler ; un pipeline non contrôlé ne devrait pas en décider.
Pour les déployeurs relevant de la catégorie définie à l’article 27, sous réserve de ses exceptions, fournissez les
éléments relatifs aux flux de données, à la population et aux garanties nécessaires à l’analyse d’impact sur les droits fondamentaux.

17
Page 18
Évaluez séparément l’applicabilité et le calendrier des articles 72–73, y compris leurs
dispositions transitoires.60
Test. Sélectionnez une alerte de surveillance et vérifiez qu’une personne responsable peut identifier le
système et la version du jeu de données, retrouver les preuves et suivre le circuit d’examen et de
remontée. Vérifiez que les instructions et la documentation technique décrivent la même
configuration mise à disposition. Réussir ce test ne permet pas de déterminer si un incident doit
légalement être signalé.

8.4 Garder les limites visibles
Réexaminez les contrôles concernés lorsque les autorisations, les pipelines, les modèles ou les procédures de reprise
procédures de restauration changent. Vérifiez que les garanties fonctionnent toujours là où les données sont traitées.
Des tests réussis n’établissent ni la stricte nécessité ni une base au titre de l’article 6.18 L’article 4a(2)
ne crée pas d’obligation générale de procéder à des tests de biais en dehors des
obligations applicables.61 Consignez le périmètre à haut risque évalué, les dates d’application, les exclusions et
le régime distinct des modèles à usage général dans le dossier de passation.10 La gestion de la qualité,
l’évaluation de la conformité, la documentation technique et la responsabilité organisationnelle
dépassent le cadre de l’entrepôt et exigent un fonctionnement continu.

9. Conclusion
La capacité de l’entrepôt à se souvenir est précieuse précisément là où la suppression fait mal :
reconstituer une décision, vérifier une nouvelle source de biais ou expliquer un résultat antérieur.
Les restrictions et obligations d’effacement du RGPD continuent de s’appliquer, aux côtés des exigences applicables de l’AI Act
exigences. La suppression contrôlée est possible, mais son périmètre détermine quelles preuves
survivent et à quelles questions on ne pourra plus répondre. Ces choix relèvent de la
conception, avec un responsable et une finalité licite pour ce qui subsiste.
Choisissez l’unité de suppression avant le chargement. Reliez le premier des deux déclencheurs de l’article 4a
déclencheurs à un workflow qui atteint les dérivés, les journaux et les copies récupérables. Testez
si une restauration ou un nouveau chargement source fait réapparaître la valeur. Préservez la méthode,
les décisions et les résultats qui peuvent licitement subsister, et dites ce qu’ils ne permettent plus de prouver. Un
Vault utile doit pouvoir expliquer son historique — et exécuter une décision justifiée d’en effacer
une partie.

Annexe. Contexte juridique et limites d’interprétation
A.1 De l’article 10(5) à l’article 4a
L’exception initiale est apparue sans explication claire de son origine. Arnoud Engelfriet
fait remonter l’article 10(5) à une proposition de la Commission dont les documents d’accompagnement laissaient cette
question sans réponse. L’EDPB et l’EDPS en ont contesté l’articulation avec le RGPD en

18
Page 19
2021. Le Parlement a ensuite ajouté des garanties ainsi que le caractère exceptionnel de
autorisation ; le Conseil a ajouté la référence à l’article 9(2)(g), reprise au considérant 70 de
AI Act de 2024.62,63
Le règlement 2026/1744 a supprimé l’article 10(5) et inséré l’article 4a, en conservant les six
garanties tout en élargissant les catégories d’acteurs pouvant se prévaloir de l’autorisation. Les
renvois de l’article 10 modifié pointent vers l’article 4a(1). L’article 2(7) continue de
préserver le RGPD, sous réserve des ajustements prévus par l’AI Act, et le considérant 9 rattache la détection
et la correction des biais à un motif d’intérêt public important et à l’article 9(2)(g) du RGPD.
L’architecture doit fonctionner dans ce cadre juridique.64,65,66

A.2 L’article 6 exige une base distincte
Le règlement 2026/1744 ne fournit aucun fondement général au titre de l’article 6 pour le traitement lié aux biais.
Ses références au RGPD comprennent l’article 9(2)(g) au considérant 9 et l’article 35 dans la disposition modifiée
relative à l’analyse d’impact ; l’article 4a s’applique en sus du RGPD. Le
considérant antérieur relatif aux bacs à sable réglementaires mentionne, lui, expressément à la fois l’article 6(4) et
l’article 9(2)(g). Ces différences plaident pour une évaluation distincte du fondement de l’article 6
et de la voie de l’article 9, plutôt que de les déduire tous deux de l’article 4a.16,17,67
Engelfriet lit l’exception initiale comme une dérogation étroitement bornée et dépendante,
dont le caractère exceptionnel renvoie à des biais systémiques graves. C’est son interprétation,
et non un seuil légal exprès. La formulation plus large de l’article 4a(2) compte aussi. Lorsque
les fondements ou les garanties ne peuvent être établis, les choix possibles sont une autre
technique licite, une activité plus restreinte, ou l’absence de traitement.68,18

A.3 Distinguer le droit adopté de la proposition relative au RGPD
Le Digital Omnibus distinct relatif au RGPD a proposé une voie pour les données de catégorie particulière
rencontrées incidemment lors du développement et de l’exploitation de l’IA, ainsi qu’une disposition sur l’intérêt légitime propre à l’IA. Contrairement à l’AI Omnibus adopté, il reste une
proposition. Ses dispositions ne peuvent autoriser aucun traitement actuel.69
L’EDPB et l’EDPS ont jugé qu’une disposition spécifique sur l’intérêt légitime en matière d’IA
inutile : le cadre existant s’applique déjà au cas par cas. Ils ont aussi demandé
une articulation plus claire entre les voies proposées pour les données sensibles. Le document du Conseil ST
10729/26, daté du 22 juin 2026, consigne le compromis alors en discussion. Conservez
registres d’autorisation versionnés au fil de l’évolution du droit ; une éventuelle autorisation future n’a pas
sa place dans la configuration de traitement actuelle.70

A.4 Placer les garanties là où le traitement a lieu
Une garantie inscrite dans une politique peut échouer là où les données sont effectivement traitées. Engelfriet
rattache la protection structurelle au raisonnement de la Cour de justice dans La Quadrature du
Net, un arrêt rendu dans un contexte de conservation différent. Ce rapprochement étaye un

19
Page 20
argument architectural attribué à son auteur ; la Cour n’a prescrit ni Data Vault, ni une partition, ni
un AI-Mart.71,72,73
Une obligation d’atténuer les biais peut coexister avec des restrictions sur les données nécessaires pour les étudier.
Les tests facultatifs de l’article 4a(2) restent facultatifs, et les obligations pesant sur les fournisseurs de systèmes à haut risque
systèmes ne peuvent être étendues par analogie aux modèles à usage général. Les contrôles opérationnels
dépendent donc de l’acteur, du système et de la finalité évalués, tout au long de leur utilisation.74,61,10

Notes
1.

4.

Regulation (EU) 2026/1744 of the European Parliament and of the Council of 8 July 2026
amending Regulations (EU) 2024/1689, (EU) 2018/1139 and (EU) 2023/1230 as regards the
simplification of the implementation of harmonised rules on artificial intelligence (Digital
Omnibus on AI), JO L, 24 juillet 2026 (ELI : data.europa.eu/eli/reg/2026/1744/oj) ; entré en vigueur le
troisième jour suivant la publication (art. 4).
Règl. 2026/1744, art. 1(9)(b) (« le paragraphe 5 est supprimé »).
Règl. 2026/1744, art. 1(6), qui insère l’art. 4a dans le règlement (UE) 2024/1689. Les références aux articles de
l’AI Act renvoient ici au texte consolidé 02024R1689 — EN — 27.07.2026 — 001.001, à l’exception des
des considérants, cités d’après leurs textes respectifs au JO.
AI Act, Art. 4a(2).

5.
6.
7.

AI Act, art. 4a(2), dernière phrase.
AI Act, Art. 10(2)(f) and (g).
AI Act, Art. 10(3).

8.

Règl. 2026/1744, considérant 9 (dernière phrase : la base juridique "should apply from the date of entry into
application of that Regulation") ; AI Act, Art. 113 (chapitres I et II applicables à compter du 2 février 2025 ;
le point a) modifié exclut les nouvelles interdictions de l’art. 5, applicables à compter du 2 décembre 2026
— sans incidence sur l’art. 4a).

9.

AI Act, art. 113(c), tel que modifié par le règl. 2026/1744, art. 1(40) (2 décembre 2027 pour les systèmes
relevant de l’art. 6(2) ; 2 août 2028 pour les systèmes relevant de l’art. 6(1)) ; AI Act, Art. 2(2) (pour les systèmes liés aux
produits énumérés à l’annexe I, section B, seuls l’art. 6(1), l’art. 60a et les art. 102 à 112 s’appliquent ; l’art. 10
ne s’applique donc pas).

10.

AI Act, art. 113(c), art. 51-56 et chapitre V ; art. 2(2) (qui limite l’application des obligations du chapitre III
obligations aux systèmes liés aux produits énumérés à l’annexe I, section B).

11.

AI Act, Art. 10(1), (2)(a)–(h) and (6), as amended by Regulation (EU) 2026/1744, Art. 1(9).
Le paragraphe 6 limite les exigences visées aux jeux de données de test servant au développement de systèmes à haut risque
systèmes n’utilisant pas de techniques d’entraînement de modèles. Texte consolidé : https://eur-lex.europa.eu/legalcontent/EN/TXT/?uri=CELEX:02024R1689-20260727.
AI Act, art. 26(1) et (4) : utilisation conforme à la notice d’utilisation ; données d’entrée pertinentes et suffisamment représentatives,
au regard de la destination, dans la mesure où le déployeur les maîtrise.

2.
3.

12.
13.

Regulation (EU) 2016/679 (GDPR), OJ L 119, 4 May 2016, Art. 9(1).

14.

RGPD, art. 6(1), 6(3), 9(1)–(2), 17(1)–(3). L’article 6(1)(f) exclut le traitement effectué par les autorités publiques dans
l’exécution de missions publiques ; les points c)/e) exigent la base juridique de l’article 6(3). Affaire C-667/21
Krankenversicherung Nordrhein EU:C:2023:1022, points 73–79 : application concurrente des exigences des articles 5, 6 et 9
exigences. https://eur-lex.europa.eu/eli/reg/2016/679/oj/eng.

15.

Engelfriet (n 62) 3–5; Case C-667/21 Krankenversicherung Nordrhein EU:C:2023:1022, paras 73–
78, not. 78, et dispositif, point 3 (le traitement fondé sur l’art. 9(2)(h) "must, in order to be lawful,
not only comply with the requirements arising from that provision, but must also satisfy at least
one of the conditions of lawfulness set out in Article 6(1)"). L’article indique expressément qu’il "does not attempt
to resolve which legal basis under Article 6 GDPR might apply to bias mitigation activities": ibid 2.
Règl. 2026/1744, passim ; les seules références au RGPD au niveau des dispositions sont le considérant 9 (art. 9(2)(g)) et l’art.
1(13) (qui modifie l’art. 27(4) de l’AI Act en renvoyant à l’art. 35 du RGPD).

16.

20
Page 21
17.
18.

AI Act, Art. 4a(1), chapeau.
Engelfriet (n 62) 2, 4 (un fondement de l’article 6 supposé exister ailleurs ; la question est expressément laissée
sans réponse) et 10 (la solution de repli lorsque les conditions ne sont pas remplies : des techniques moins efficaces ou le
risque de non-conformité).

19.

Van Bekkum (n 24), §4.6.2 (l’article 6(1)(c) du RGPD combiné à l’article 10(2) de l’AI Act comme "a concrete legal
obligation").
Affaire C-621/22 Koninklijke Nederlandse Lawn Tennisbond EU:C:2024:858, points 36–57 (les trois
conditions cumulatives au point 37 ; intérêt commercial aux points 47 à 49) et dispositif (un intérêt purement
commercial peut constituer un intérêt légitime à condition d’être licite, que le traitement soit
strictement nécessaire à sa réalisation et que les intérêts de la personne concernée ne prévalent pas).
AI Act, Art. 4a(1)(a).

20.

21.
22.
23.

24.

25.

AI Act, Art. 4a(1)(f).
Žliobaitė & Custers, 'Using sensitive personal data may be necessary for avoiding discrimination
in data-driven decision models' (2016) 24 Artificial Intelligence and Law 183; Veale & Binns,
'Fairer machine learning in the real world: Mitigating discrimination without collecting sensitive
data' (2017) 4(2) Big Data & Society, art 2053951717743530.
Sur la nécessité de l’attribut protégé pour valider une variable indirecte (proxy), voir M. van Bekkum, 'Using
sensitive data to de-bias AI systems: Article 10(5) of the EU AI Act' (2025) 56 Computer Law &
Security Review 106115, §2 (un fournisseur "must collect ethnicity data" pour établir qu’un attribut
est un proxy).
Veale & Binns (n 23), qui proposent des tiers de confiance détenant les attributs sensibles et renvoyant des
statistiques d’équité.

26.
27.

AI Act, Art. 4a(1)(d).
RGPD, considérant 26 (caractère identifiable apprécié au regard de « l’ensemble des moyens raisonnablement susceptibles d’être utilisés » ;
les données pseudonymisées restent des données personnelles). Sur la frontière entre données personnelles et non personnelles, voir M.
Finck & F. Pallas, 'They who must not be identified — distinguishing personal from non-personal
data under the GDPR' (2020) 10(1) International Data Privacy Law 11, 12–13 ("perfect
anonymization is impossible" et la définition juridique "needs to embrace the remaining risk" ; le
critère de probabilité raisonnable du considérant 26 comme frontière opérante).

28.
29.

AI Act, Art. 4a(1)(b).
AI Act, Art. 4a(1)(c).

30.
31.
32.
33.

AI Act, Art. 4a(1)(e).
AI Act, Art. 10(2)(b).
AI Act, Art. 10(2)(d).
AI Act, Art. 10(2)(c).

34.
35.

AI Act, Art. 10(3).
AI Act, Art. 10(4).

36.

Scalefree International GmbH, 'AI Act Insight: Ensuring Responsible AI for Your Business'
(scalefree.com/blog/artificial-intelligence/ai-act-insight-ensuring-responsible-ai-for-yourbusiness/, published 29 October 2024, last updated 21 May 2026; accessed 2 September 2026):
l’AI-Mart comme "a specialized data mart" pour des données d’entraînement d’IA préparées et validées, les journaux du modèle étant
rechargés dans l’entrepôt.
A. Gadotti, L. Rocher, F. Houssiau, A.-M. Creţu & Y.-A. de Montjoye, 'Anonymization: The
imperfect science of using data while preserving privacy' (2024) 10(29) Science Advances
eadn7053 (typologie des attaques sur les données agrégées : inférence d’appartenance, inférence d’attribut,
et reconstruction, l’attaque par différenciation étant décrite comme "a very simple kind of inference
attack" ; les données agrégées "do not inherently protect against privacy attacks").

37.

38.

Linstedt & Olschimke (n 41) ch 5.3.6 (satellites calculés dans le Business Vault).

39.

D. Krneta, V. Jovanović & Z. Marjanović, 'A direct approach to physical Data Vault design' (2014)
11(2) Computer Science and Information Systems 569, 569–570.
A. Vines & R.-E. Samoila, 'An Overview of Data Vault Methodology and Its Benefits' (2023) 27(2)
Informatica Economica 15, 17–21 (clés de hachage permettant le traitement parallèle des hubs et des satellites ;
mécanismes de record source et de load date) ; Linstedt & Olschimke (n 41) chs 4.3–4.5.

40.

21
Page 22
41.

D. Linstedt & M. Olschimke, Building a Scalable Data Warehouse with Data Vault 2.0 (Morgan
Kaufmann 2016) ch 4.5.1 ("Because the history of the data needs to be preserved, you are not
allowed to update or modify the data in the satellite. The only exception to this rule is the Load
End Date attribute") et ch. 6 (les tables PIT et bridge comme entités d’aide aux requêtes du Business Vault).

42.
43.

AI Act, Art. 12(1).
AI Act, art. 12(2)–(3) ; la liste détaillée de l’art. 12(3) s’applique aux systèmes visés à l’annexe III, point
1(a).

44.
45.

Scalefree (n 36).
Linstedt & Olschimke (n 41) ch 5.3.3 (satellites de suivi de statut chargeant les pistes d’audit CRUD ; journalisation
des lectures "for security reasons to provide information about who accessed which data").
AI Act, art. 11 et annexe IV ; art. 16–17 ; art. 18(1) (documentation énumérée, jusqu’à dix ans après la
la mise sur le marché ou la mise en service) ; Arts. 19(1), 26(6) (journaux générés automatiquement sous le
contrôle de l’acteur, conservés pendant une durée adaptée à la finalité d’au moins six mois, sauf si le droit
notamment le droit de la protection des données, n’en dispose autrement). La conservation de la documentation
n’autorise pas en soi la conservation de données personnelles d’entraînement.
AI Act, art. 4a(1)(e) (anciennement art. 10(5)(e)).
Van Bekkum (n 24), §4.6.1.

46.

47.
48.
49.
50.

Scalefree (n 54).
Linstedt & Olschimke (n 41) ch 4.3.2.1 : la clé de hachage "replaces the sequence number from the
Data Vault 1.0 standard", est calculée à partir de la clé métier, "can be regenerated" et est multiplateforme ; autrement dit, aucun séquenceur central n’est nécessaire et les chargements se parallélisent de manière déterministe.

51.

Belen-Saglam et al. (n 55) §4.6.1 ('Hashing out') et texte correspondant (suppression de clés de chiffrement
suppression envisagée comme mise en œuvre du droit à l’oubli, avec mention des avis contraires).
L’effet technique ne s’étend qu’aux données qui restent chiffrées sous la clé détruite ;
les copies en clair ou chiffrées indépendamment exigent un traitement distinct. Politou, Alepis &
Patsakis (n 55) traitent de l’effacement dans les infrastructures résistantes.
Linstedt & Olschimke (n 41) ch 6.1.1 (les entrées PIT utilisent la clé de hachage d’un satellite et un horodatage de chargement ;
les enregistrements fantômes remplacent les références manquantes afin que les équi-jointures restent possibles). Après l’effacement d’une ligne réelle
référencée, les entrées PIT concernées doivent être reconstruites ou redirigées vers l’enregistrement fantôme ; la simple
existence de celui-ci ne modifie pas une référence PIT obsolète.
Linstedt & Olschimke (n 41) ch 6.1.2 (fenêtres PIT gérées et logarithmiques ; les instantanés supprimés
"could be rebuilt using the same algorithm that has built them in the past").
Voir les contenus publiés par Scalefree International GmbH, cités à titre d’exemple de
documentation : 'Use Data Vault 2.0 to Tackle GDPR' (publié le 20 décembre 2024, mis à jour le 11
mai 2026), qui décrit la séparation des attributs touchant à la vie privée et la suppression d’enregistrements du
satellite de données personnelles tout en conservant le reste de l’historique de l’entrepôt ; et 'Implementing GDPR in Data
Warehousing' (publié le 11 juillet 2022, mis à jour le 16 avril 2026). Tous deux consultés le 2 septembre
2026. Les mêmes contenus relèvent qu’une clé métier peut elle-même contenir des données à caractère personnel ; les
conservées doivent donc être évaluées séparément.

52.

53.
54.

55.

E. Politou, E. Alepis & C. Patsakis, 'Forgetting personal data and revoking consent under the
GDPR: Challenges and proposed solutions' (2018) 4(1) Journal of Cybersecurity tyy001; R. BelenSaglam et al., 'A systematic literature review of the tension between the GDPR and public
blockchain systems' (2023) 4(2) Blockchain: Research and Applications 100129; A. Zafar,
'Reconciling blockchain technology and data protection laws: regulatory challenges, technical
solutions, and practical pathways' (2025) 11(1) Journal of Cybersecurity tyaf002 (abstract).

56.

AI Act, art. 26(6) (nous soulignons).

57.

H. Xu, T. Zhu, L. Zhang, W. Zhou & P.S. Yu, 'Machine Unlearning: A Survey' (2024) 56(1) ACM
Computing Surveys, art 9, DOI 10.1145/3603620 (qui distingue le réentraînement, le désapprentissage exact et le
désapprentissage approché, et examinant leur coût et leurs limites).
I. Marco-Pérez, B. Pérez, Á.L. Rubio García & M.A. Zapata, 'The Many Faces of Data Deletion: On
the Significance and Implications of Deleting Data' (2026) 58(7) ACM Computing Surveys, DOI
10.1145/3779299; EDPB Opinion 28/2024 on certain data-protection aspects related to the
processing of personal data in the context of AI models, points 29-49 (savoir si un modèle est

58.

22
Page 23
59.

60.

61.
62.

anonyme ou contient des données personnelles exige une évaluation au cas par cas des risques d’extraction et de
requête).
AI Act, art. 13(1)–(3), 14, 15 et 26(2) : notice d’utilisation, contrôle humain, exactitude, robustesse et
cybersécurité ; contrôle par un déployeur compétent, formé et habilité. Il s’agit d’obligations au niveau du système,
et non de conceptions d’entrepôt prescrites.
AI Act, art. 27, 26(9), 72, 73, 26(5), 111 et 113. L’article 27 concerne la catégorie de déployeurs visée
visés ; l’article 26(9) s’applique lorsqu’une AIPD est requise. L’article 72 porte sur la surveillance par le fournisseur ;
l’article 26(5), la surveillance par le déployeur et la remontée des alertes. Ces obligations dépendent de l’acteur, du système,
des exceptions légales et des dispositions transitoires. Les articles 72 et 73 échappent au report propre au chapitre III.
Les dispositions sectorielles pertinentes doivent également être évaluées.
AI Act, art. 4a(2), dernière phrase.

63.
64.

A. Engelfriet, 'Permitted by design? Article 10(5) AIA, sensitive data, and the legal illusion of bias
correction' (2026) 16(1) International Data Privacy Law ipaf035, 1–10 (DOI: 10.1093/idpl/ipaf035),
2–3 ("no publicly stated rationale for why such a clause was included"); EDPB-EDPS Joint Opinion
5/2021 (18 June 2021), quoted ibid 2 and 4.
Engelfriet (n 62) 2–3; AI Act (2024 text), recital 70, OJ L 2024/1689, 12 July 2024.
Reg. 2026/1744, Art. 1(9)(b) and Art. 1(6).

65.

AI Act, art. 10(1), 10(6) et 2(7), tels que modifiés.

66.
67.

Reg. 2026/1744, recital 9.
AI Act (2024 text), recital 140 ("in accordance with Article 6(4) and Article 9(2), point (g), of
Regulation (EU) 2016/679"); Engelfriet (n 62) 4.

68.

Engelfriet (n 62) 1, 9–10 (l’article 10(5) "best understood not as a general permission for fairnessoriented processing, but as a clause of last resort, invocable only in narrowly circumscribed cases
where systemic bias rises to the level of a serious incident").

69.

Proposal for a Regulation amending Regulation (EU) 2016/679 and others as regards
simplification of the digital legislative framework (Digital Omnibus), COM(2025) 837 final, 19
novembre 2025, art. 3(3) (projet d’art. 9(2)(k) du RGPD pour les données de catégorie particulière apparaissant dans le
développement de l’IA, sous réserve des garanties prévues par le projet d’art. 9(5)) et Art. 3(15) (projet d’art. 88c sur les
intérêts légitimes dans le développement et l’exploitation de l’IA). La proposition reste en cours d’examen et n’est pas
citée comme droit en vigueur.
EDPB-EDPS Joint Opinion 2/2026 on the Digital Omnibus (10 février 2026), points 39-41 (une
disposition dédiée à l’intérêt légitime en matière d’IA est inutile, car le cadre existant de l’art. 6(1)(f)
s’applique au cas par cas) et point 52 (demandant une articulation plus claire entre les
voies proposées au titre de l’art. 9). Document du Conseil ST 10729/26, 22 juin 2026, Mandate for negotiations
with the European Parliament, qui consigne le compromis de la présidence soumis au Coreper pour
confirmation ; il ne prouve pas qu’un mandat de négociation ait été retiré le 30 juin 2026. Sur
la présentation par la Commission des dispositions de l’AI-Omnibus et du GDPR-Omnibus comme indépendantes,
voir le document de travail du Conseil WK 251/2026 INIT, 9 janvier 2026.

70.

71.

Engelfriet (n 62) 7–8.

72.

Joined Cases C-511/18, C-512/18 and C-520/18 La Quadrature du Net and Others
EU:C:2020:791, point 132 (dans le contexte des points 130–136).

73.

Engelfriet (n 62) 8 : les garanties devraient être 'embedded into the architecture of processing, not
appended post hoc' - prolongement, par Engelfriet, de la jurisprudence La Quadrature, repris ici en le lui attribuant. Voir
aussi RGPD, art. 25 (protection des données dès la conception et par défaut).

74.

Engelfriet (n 62) 10 ("The compromise, however, comes at a cost … the obligation to mitigate
persists, yet the lawful ability to process the data needed to fulfil it is curtailed").

23
Page 24
Note sur les sources
Les articles de l’AI Act sont cités d’après le texte consolidé 02024R1689—27.07.2026—001.001 ; les considérants, d’après
l’acte publié au Journal officiel qui les a introduits. La consolidation est un
outil documentaire ; seuls les actes publiés au Journal officiel font foi. Les articles du RGPD sont cités d’après
le texte consolidé intégrant le rectificatif de 2018 ; les considérants, d’après le JO L 119. Le statut législatif et
la cartographie légale élargie ont été revérifiés au regard des sources officielles citées le 2
septembre 2026. Les références de praticiens conservent leurs dates de publication, de mise à jour et
de consultation enregistrées. Les contenus de la société de conseil fournissent des exemples publics de pratique Data Vault.
exemple de recrutement, les choix d’architecture, les dossiers de preuves et les contrôles d’acceptation sont
des propositions illustratives, et non des conceptions légales prescrites. Les opinions exprimées et les erreurs éventuelles sont celles de l’auteur.

24